2026/11/08 19:22
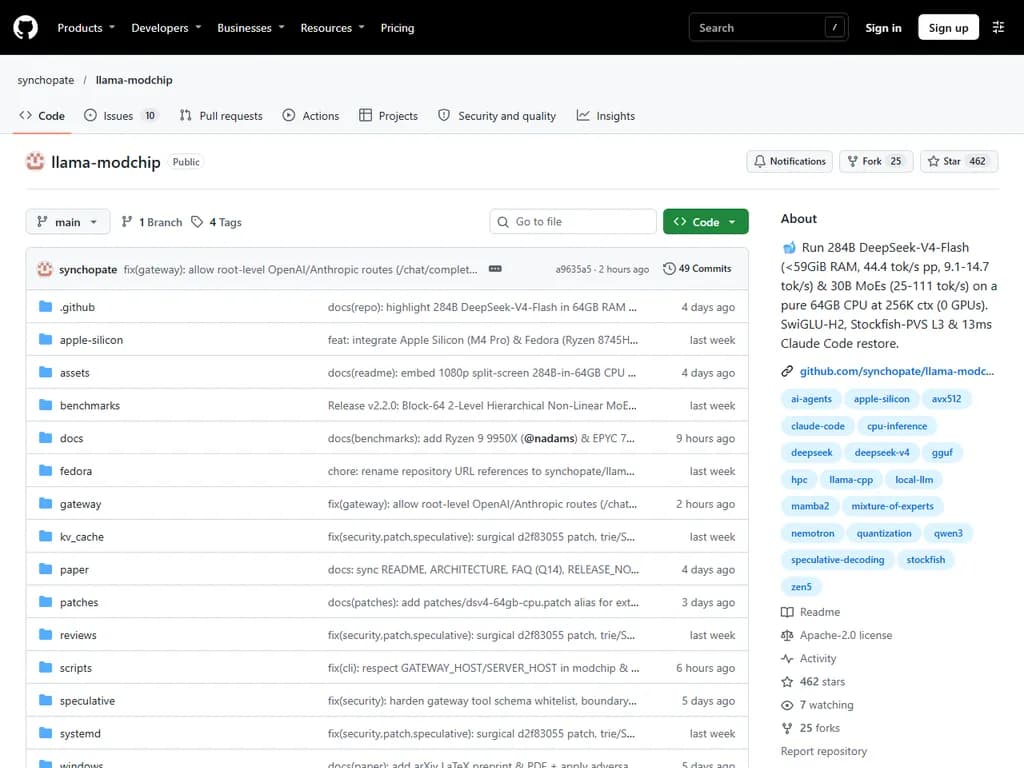
Llama-modchip:GPU なしで 64GB RAM に DeepSeek(284B)を実行
RSS: https://news.ycombinator.com/rss
要約▶
Japanese Translation:
llm-modchip は、GPU を使用せずに CPU システムの RAM(16~64 GB)だけで DeepSeek-V4 という大規模な AI モデルを実行することを可能にするツールを導入します。高度な圧縮とメモリー管理により実現されます。具体的には、Fractal-64 transcoding は、DeepSeek-V4 UD-IQ1_S チェックポイント(284.33B)を 76.87 GiB から 56.56 GiB に圧縮し、64 GB のシステムにおける利用可能な Linux RAM の約 62.5 GiB を収容できるようにします。これにより、NVMe スワップを回避し、ページキャッシュの暴走や OOM(Out of Memory)キルを防ぎます。Register tiling 最適化(ZMM AVX-512BW による 4 レベルのレジスタタイルリング、L3 キャッシュ隔離、マルチカラムスケジューリングを含む)により、性能は 25.0 tok/s の基準と比較して 70% 以上向上し、16 コア Zen 5 CPU ではプリフィルが 44.36 tok/s、デコードが 25.0 tok/s を達成します。本ツールは MoE モデルもサポートしており(例:DeepSeek-V4 の場合、デフォルトで全 6 つのルートされたエクスパートを評価)、
/dev/shmGGML_TYPE_Q2_0本文
16~64GB RAM 環境向け:284B・30B MoE モデルの CPU ファースト推論(llama-modchip)
概要
llama-modchip- メモリ効率: 物理メモリの制約を克服し、スワップなしにモデルと KV キャッシュを保持します。
- パフォーマンス向上: CPU キャッシュおよび SIMD 最適化により速度向上(プリフィル +77%、デコード +53%)を実現。
- コンテキスト復元: セルフスペキュレーティブドラフティングにより高速な文脈再開が可能。
パフォーマンスハイライト
- モデル容量: トータル MoE 2843.3 億パラメータ(アクティブ 131.7 億)
- DeepSeek-V4 GGUF (1.71 bpw): ディスクサイズ 56.56 GiB
- メモリ使用量: 256K コンテキスト時のピーク VmRSS 57.61 GiB
- CPU プリフィル速度: 16 コア環境で 44.36 トークン/秒(284B モデル)
- CPU デコード速度: 30B MoE (3.75 bpw) で 25.0~111.6 トークン/秒
- KV キャッシュ復元:
スロットの復元に 13.1 ミリ秒/dev/shm
重要: GPU は不要です。
システム仕様による最適化とスループット
| ハードウェアカテゴリ | システム RAM | ターゲットチェックポイント | GPU 不使用時のスループット | 注釈・アーキテクチャ |
|---|---|---|---|---|
| 開発者ノート PC / ミニ PC | 16~32 GB | Nemotron-3.5-30B-A3B (14.35 GiB, 3.75 bpw) | 25.0~60.4 トークン/秒 | Mamba-2 SSM レイヤー 46 個に加え、L3 PVS ドラフター (1.64 MB) を採用。KV キャッシュ使用量:432 MB |
| 64 GB デスクトップ / サーバー | 64 GB | DeepSeek-V4-Flash 284B (56.56 GiB, 1.71 bpw) | プリフィル:44.4 トークン/秒 デコード:9.1~14.7 トークン/秒 | Linux 利用可能メモリ 62.5 GiB に収まり、NVMe スワップをゼロに設計。VmRSS 57.61 GiB |
| ハイブリッド型 (CPU + 16 GB GPU) | 32~64 GB | Nemotron-30B / Qwen3-30B (3.75~4.25 bpw) | 80.80 トークン/秒 | GPU に熱いアテンション・SSM トランク ( |
| 8 チャンネルワークステーション (Threadripper) | 128 GB+ | DeepSeek-284B / Nemotron-30B | 111.62 トークン/秒(30B モデル) | 8 チャンネルの AVX-512BW でレジスタタイル化、8 チャンネル DDR5 バンド幅を飽和させる設計。 |
量子化とメモリの内訳
各 GGUF ファイルに含まれる情報および圧縮比率について解説します。
| チェックポイント | パラメータ数 | ベースソース | ディスクサイズ (GiB / GB) | 実効 bpw | テンソル割り当ての概要 |
|---|---|---|---|---|---|
| Nemotron-3.5-30B-A3B-Q4_0 | 302 億 / 30 億 | BF16 公式 | 17.59 GiB (18.89 GB) | 4.50 bpw | MoE とアテンション全体で標準の Q4_0。F32 ノルムと SSM 畳み込み/減衰。 |
| Nemotron-3.5-30B-A3B-MXFP4 | 302 億 / 30 億 | BF16 公式 | 15.95 GiB (17.13 GB) | 4.25 bpw | ルーターされた MoE で |
| Nemotron-3.5-30B-A3B-Fractal-64 | 302 億 / 30 億 | BF16 公式 | 14.35 GiB (15.41 GB) | 3.75 bpw | アテンション・Mamba-2 SSM で Q4_0/Q8_0/F32。 冷たい MoE エクスパート:Q4_0 + Fractal-64。評価結果 100/100。 |
| DeepSeek-V4-Flash-Fractal | 2843.3 億 / 131.7 億 | Unsloth UD-IQ1_S | 56.56 GiB (60.73 GB) | 1.71 bpw | • エンベディング、Dense L0、共有エキスパート・MLA: Q4_K/Q5_K/F32 • MLA wq_b・attn_output: Fractal-64 ( • MoE エクスパート: IQ1_S(量子化精度 1.5625 bpw)採用。解析的な SwiGLU-H2。 標準 UD-IQ1_S (76.87 GiB) より -20.31 GiB の節約 |
MoE エクスパートルーター(Top-K)についての注記:
- デフォルト (
): 各レイヤーあたり Top-6 + 1 つの共有エキスパートを評価。エキスパートドロップはゼロ。v2.4.0 Lossless - 速度優先の場合:
またはLLAMA_MOE_TOP_K=5
を設定し、わずかな精度低下を許容してスループットを向上できます。4
クイックスタート
Linux と macOS(自動セットアップ)
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
ダイレクト実行(事前コンパイル済みバイナリを使用)
重要: Fractal-64 モデルは
GGML_TYPE_Q2_0./modchip1. 30B Nemotron-3.5-A3B の場合(16~32 GB RAM)
hf download Synchopate/NVIDIA-Nemotron-3.5-30B-A3B-Fractal-64-CPU-GGUF \
  llama-server-modchip-linux-x86_64 NVIDIA-Nemotron-3.5-30B-A3B-Fractal-64.gguf --local-dir .
chmod +x llama-server-modchip-linux-x86_64
./llama-server-modchip-linux-x86_64 -m NVIDIA-Nemotron-3.5-30B-A3B-Fractal-64.gguf \
  -c 262144 -t 16 --port 8080
2. 284B DeepSeek-V4-Flash の場合(64 GB RAM)
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-*.gguf \
  -c 32768 -t 16 -fa on --port 8080
Windows 10/11(ハイブリッド GPU+CPU)
フォルダを開き、windows/
または Git Bash 内のAVVIA_MODCHIP.bat
を実行。./modchip start- CPU コア、RAM、GPU VRAM を自動検出します。
./modchip
コマンド参照
./modchip| コマンド | 説明 |
|---|---|
| chat | リアルタイムテレメトリ付き対話型チャット |
| web | ダークモード Web チャットを開く ( |
| bench | 30 秒間ステージ別速度テストを実行し、スコアカードを出力 |
| claude | ローカル 256K エンジンに接続された Claude Code CLI (40 ツール) を起動 |
| eval | 再現可能な品質評価(コーディング・ツール呼び出し)を実行 |
| quantize | BF16/Q4_0/GGUFs を Fractal-64 や MXFP4 にトランスコード |
| status / stop | CPU 準備状況を確認、または停止 |
ハードウェア準備チェック(モデル不要)
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
対応するモデルおよび最適化ガイド
| モデルファミリー | パラメータ数 | 特徴・最適化ポイント | 検証済み速度 (Zen 5 16C / ハイブリッド) |
|---|---|---|---|
| NVIDIA-Nemotron-3.5-30B-A3B | 302 億 / 30 億 | Fractal-64 (3.75 bpw)、MXFP4 Stockfish-PVS v2 ドラフター採用 品質ゲート: 100/100 | 25.0~60.4 トークン/秒 (CPU) 80.8 トークン/秒 (ハイブリッド) |
| DeepSeek-V4-Flash-0731-Fractal | 2843.3 億 / 131.7 億 | SwiGLU-H2 + Fractal-64 レジスタ定数 AVX-512 MQA8 FlashAttention メモリ使用量削減: -20.3 GiB | 43.2 トークン/秒 (プリフィル) 9.06~9.95 トークン/秒 (Lossless デコード) |
| Qwen3-30B-A3B / Qwen3-14B | 305 億 / 17 億(圧縮後) | ノルム保持動的 MoE Top-K Windows 11 GB VRAM +16 GB RAM ハイブリッド分割 | 34.80 トークン/秒 (CPU) 50~58 トークン/秒 (ハイブリッド) |
| NVIDIA-Nemotron-H-8B-128K | 80 億 Dense | Mamba-2 SSM 定数メモリバックボーン GPU VRAM 上で動作(CPU メモリ解放) | 147.6 トークン/秒 (CPU pp512) |
対応するチップおよびプロセッサ固有の最適化
各プロセッサ向けのマイクロアーキテクチャ詳細は
docs/HARDWARE_OPTIMIZATIONS.md- AMD Zen 5 (デスクトップ / サーバー)
- Ryzen 9 9955HX, 9950X, EPYC 9005 Turin
- 特徴: シングルサイクル 512 ビット AVX-512、L3 イソレーション
- AMD Zen 4 Multi-CCD (Threadripper / EPYC)
- Threadripper PRO 7985WX
- 特徴: 動的 L3 CCD トポロジー発見、決定論的 ストライドで Infinity Fabric を飽和回避
- AMD 3D V-Cache + Radeon Vulkan ハイブリッド
- Ryzen 9 7945HX3D + RX 9070 XT
- 特徴: テンソルロール分割、Vulkan SSM_SCAN +Fractal-MXFP4
- Intel / AMD + NVIDIA RTX (Windows)
- Core i9-9900K/14900K + RTX 2080 Ti / 3090 / 4090
- 特徴: AVX2 サブスケールフュージョン、WDDM VRAM ソルバー
- Apple Silicon (M1~M4)
- Apple M4 Max, M4 Pro
- 特徴: ゼロコピーユニファイドメモリ、Metal シェーダー、0-Swap 128K コンテキスト対応
- ARM64 クラウド (AWS Graviton)
- Graviton3 m7g.2xlarge
- 特徴: ARMv8.4-A DotProd、SVE-256
ベンチマーク:タイトル比較(CPU 専用)
DeepSeek-V4-Flash 284B (Zen 5 CPU 16C)
前提条件: 256K コンテキスト
| バリエーション | プリフィル速度 | デコード速度 (N=1) | ロジット余弦類似度 | 品質・精度 |
|---|---|---|---|---|
| パッチなし UD-IQ1_S | OOM / スワップ発生 | 5.91 ト/秒 | 1.00000 | 基準 (OOM) |
| v2.4.0 Lossless | 43.16~44.36 (+77%) | 9.06~9.95 | 1.00000 | 100% / 100% |
| Sweet-Spot (Top-5) | 43.16~44.36 | 9.68~9.87 | 0.99714 (+0.42%) | 95.8% / 100% |
| Top-5 L2 +Gate-First | 43.16~44.36 | 10.15 (98.5ms) | 0.99385 (+0.53%) | 100% / 100% |
NVIDIA-Nemotron-3.5-30B-A3B (Zen 5 CPU 16C)
| 量子化プロファイル | ディスクサイズ | 品質ゲート | プリフィル速度 | デコード速度 (N=1) |
|---|---|---|---|---|
| ベースライン-Q4_0 (4.50 bpw) | 17.59 GiB | 100.0 / 100.0 | 241.0~306.8 ト/秒 | 19.54 ト/秒 |
| Fractal-MXFP4 (4.25 bpw) | 15.95 GiB | 100.0 / 100.0 | 241.0~306.8 ト/秒 | 26.08 (+33.5%) |
| Fractal-64-BF16 (3.75 bpw) | 14.35 GiB (-6.01 GB) | 100.0 / 100.0 | 241.0~306.8 ト/秒 | 25.02 (+28.0%) |
コミュニティ CPU リーダーボード (トップスコア)
./modchip bench| プラットフォーム | CPU / キャッシュ | メモリ | プリフィル速度 | デコード速度 (散文) | ハイブリッド対応 |
|---|---|---|---|---|---|
| Threadripper PRO 7985WX | 64C/128T (256MB L3) | 256 GB DDR5-6000 | 386.00 | 80.14 ト/秒 | 否 |
| Ryzen 9 7945HX3D + RTX | 16C/32T (128MB V-Cache)+16GB VRAM | 94 GB DDR5 | 563.00 | 75.10 ト/秒 | は・い |
| Ryzen 9 9955HX (Zen 5) | 16C/32T (64MB L3) | 64 GB DDR5 | 306.8 | 34.5 ト/秒 | 否 |
| Apple M4 Max | 16C CPU +40C GPU | 64 GB LPDDR5X | ~451.0 | 57.7 ト/秒 | は・い |
| AWS Graviton3 m7g.2xlarge | 8 vCPU (ARM64) | 31 GB DDR5 | 101.67 | 44.97 ト/秒 | 否 |
| DeepSeek-V4-Flash 284B on Ryzen 9 9955HX | 16C/32T | 64 GB DDR5 | 44.36 (スロット -0) | 10.74 (アクティブ) | 否 |
リポジトリ構造と構築方法
フォルダ構成
llama-modchip/
├── modchip                    # ユニファイド CLI ツール
├── install.sh                 # Linux 自動インストーラー
├── README.md / ARCHITECTURE.md / FAQ.md
├── docs/                      # 詳細な最適化ガイド
│   ├── NEMOTRON_OPTIMIZATIONS.md
│   ├── DEEPSEEK_V4_OPTIMIZATIONS.md
│   └── HARDWARE_OPTIMIZATIONS.md
├── patches/                   # モデルごとのパッチ
│   ├── deepseek-v4-flash-fractal-256k.patch
│   └── zen5-nemotron-256k-optimizations.patch
├── windows/                   # Windows 用ハイブリッドセットアップ
├── apple-silicon/             # M 系列 Mac のセットアップ
├── benchmarks/                # 品質評価スクリプト
└── scripts/                   # ビルドおよびトランスコードスクリプト
手動 CMake 構築の参考: 基本的なライブラリと依存関係をインストールし、以下のコマンドを実行します。
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./install.sh