2026/11/08 19:42
マイクロコントローラ向けの JIT ビットマップテキストレンダリング
RSS: https://news.ycombinator.com/rss
要約▶
Japanese Translation:
Raph Levien が、近代の RP2350 マイクロコントローラーを用いて、クラシックな VIC-20 アーキテクチャを再構成した革新的なレトロコンピューター「vic-2350」を発表しました。本プロジェクトは美学的純粋性と効率性を最優先しており、低解像度におけるアンチエイリアシングレンダリングではなく、SRAM に格納されたビットマップフォントを利用して処理の停滞を回避しています。主要な技術的成就是「race-the-beam」というレンダリング手法であり、HSTX パーフェクシャルを通じて DVI out を用いて画面のリフレッシュレートにグラフィック出力を同期させ、フルフレームバッファを経由せずに実装されています。厳格な効率制約(約 6 サイクル/ピクセル)を維持するため、システムはコアコンポーネント用に独自言語「symbolasm」を採用し、ビデオラインの走査前の各走査ごとに最適化されたマシンコードを生成する Just-In-Time (JIT) コンパイラーを使用しています。
レンダリングパイプラインでは、アクティブオブジェクトを効率的に管理するために、インデックスを上昇順の y コーディネートでソートされたダブルバッファディスプレイリストが採用されています。フォント最適化はオーバーラップ検出によりさらに実現され、フォントフットプリントを 1140 バイトから 960 バイトに削減しています。テキストオブジェクトは文字列、フォントポインタ、色を格納し、特定メタデータの扱いを有します。システムは AI(具体的には Claude)を活用して Rust のドラフトを symbolasm に翻訳し、最適化を洗練させることで、レガシースタイルのハードウェアが現代のようなスループットを実現できることを実証しています。この実装は、歴史的な Blit システムと比較してほぼ 3 オーダー以上の大まかな性能向上を達成しており、マイクロコントローラー上の低レベルプログラミングが、16 ビット RGB 変換などの高速度動作を約 1.75 サイクル/ピクセルで維持できることを示しています。これにより、開発者に対して将来の高解像度レトロコンピューティングのための強力なブループリントを提供します。
本文
RP2350 向けビットマップテキスト高速描画技術:「ビームレース」レンダラーと JIT コンパイラ
Raph Levien 氏による、80 年代の家庭用コンピュータを現代風に再解釈したプロジェクト**「vic-2350」**における、RP2350 マイクロコントローラー上での高速テキスト描画手法に関する技術解説です。
プロジェクト背景とアーキテクチャ選択
- プロジェクト概要: 「vic-2350」では、80 年代のスタイルを再現しつつ現代の技術を適用しています。
- フォント選定:
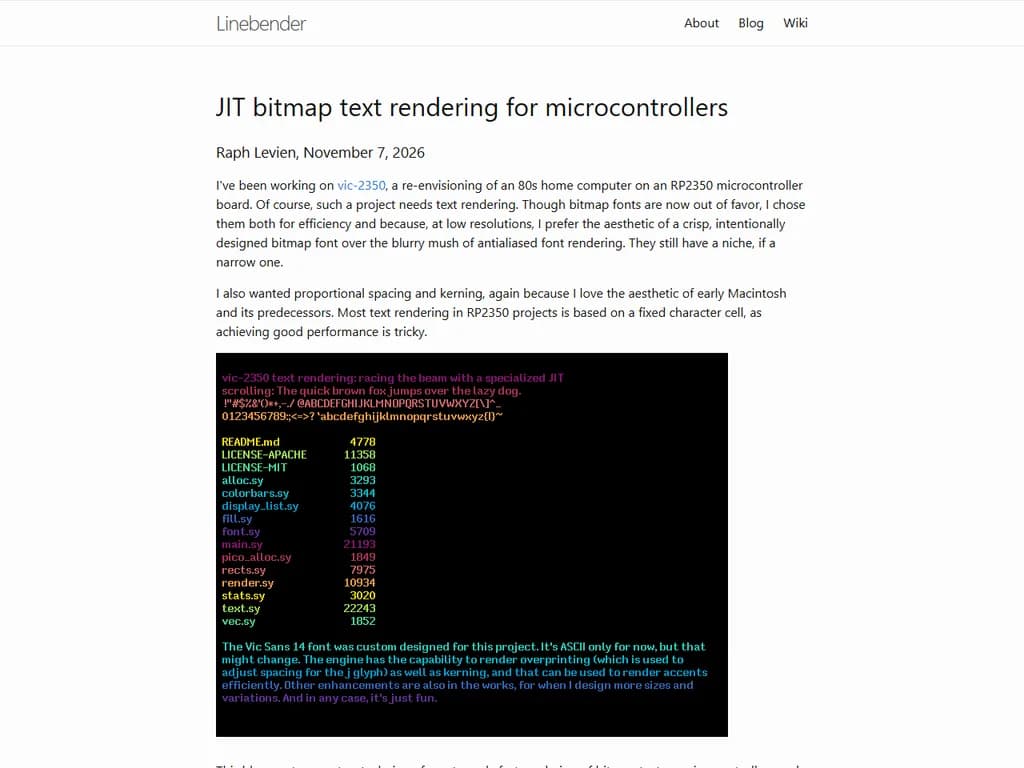
- ビットマップフォントを採用しました。アンチエイリアスによるぼやけた文字よりも、意図的にデザインされたシャープな文字の方が低解像度において美しいためです。
- 初期の Macintosh やその前身機への敬意から、比例幅設定とキエリング(字下げ調整)も実装されています。
- 描画方式:
- 一般的な固定文字セル方式ではなく、「ビームレース(Racing the Beam)」方式を採用しました。
- 理由: RP2350 の SRAM は約 520KB と限られているため、フレームバッファ方式では解像度や色深度に制約が生じます。一方、ビームレース方式ならスキャンライン毎にビデオバッファを直接充填でき、豊富なビジュアル表現と低い遅延を実現できます。
- パフォーマンス要件:
- 画素当たり約6 サイクルという厳しい予算があります。
- この予算内に収める余地が大きいほど、他のグラフィックオブジェクトやアプリ機能にリソースを割くことができます。
レンダリングパイプラインと最適化手法
ディスプレイリストによる管理
- 描画オブジェクトのリスト(ディスプレイリスト)を実装し、ダブルバッファリング方式で運用します。
- 非同期処理: アプリケーションはレンダリング中に他の作業を行い、垂直同期(vsync)時にディスプレイリストをスワップします。
- メモリ効率: ディスプレイリストはメモリ効率的であり、インデックスは y 座標昇順にソートされています。
- アクティブリスト: レンダラーは現在のスキャンラインと交差するオブジェクトのみ(サブセット)を維持し、効率的に処理します。
スラッシュ空間と専用アロケータ
- 描画準備やビットマップ割り当てには**「スラッシュ空間」**を使用します。
- 専用の高速かつ決定論的なビットマップアロケータを実装しています。
テキスト描画オブジェクトとフォントデータ構造
オブジェクト設計
- 最小限のメモリ使用: RAM が貴重であるため、テキストは文字列(1 バイト/文字)、フォントポインタ、色情報のみで実装します。
- JIT コード生成:
メソッド実行時に JIT コードをオンザフライで生成し、文字列を展開・暗号化します。start - 2 ステージレンダリング:
- ステージ 1: JIT で 1 ピクセルあたり 1 ビットのバッファを生成。
- ステージ 2: そのバッファを 16 ビット/ピクセルの RGB(565 フォーマット)に展開(約 1 サイクル/サイクルの速度)。
コンパクトなフォントパックリング
- 「インク」のみ保存: フォント高さに等しい幅の画像として、文字の黒い部分(インク)のみを格納。
- 最適化による削減: 余白やオーバーラップを検出・排除し、フォントビットマップサイズを1,140 バイトから 960 バイトへ削減。
- SRAM 必須: フォントは SRAM に格納され、フラッシュメモリ使用時のストールを防ぎます。
ギlyph メタデータ
- コンセプチュアルに 4 つのフィールドを 32 ビット整数に緊密にパック:
- インクの X 位置と幅
- 左側の余白(ベアリング)
- 進捗量(Advance)
自動キエリング (Dot Product Kerning)
- 手法: 各ギlyph の右側ベクトルと次のギlyph の左側ベクトルの AND 計算を行い、結果の
でピクセル数を決定します。これはドット積です。popcount - 効率性: テーブルはギlyph 当たり 2 バイトで済みます。
- 実装: キエリングテーブルを手動構築(または自動化ツール化)し、負のスペース文字として表現されます。
- 例:
やT
の右側、小文字とY
の左側に設定されることが多いです。A
- 例:
- 効果: 間隔の不規則性を防ぎ、テキスト品質を大幅に向上させます。
JIT コンパイラによる極限性能
レジスタ割り当て戦略
JIT 生成コードでは以下のようにレジスタが割り当てられます:
: パッキングされたフォントビットマップの行先頭r0
: 出力バッファ(1 ピクセル/1 ビットイメージ)r1
: 出力ビットマップの蓄積器r2
: ギlyph ビットデータ処理用r3-r4
コード最適化例
基本的なギlyph 追加コードでは、結果使用遅延を解決するために命令順序をずらすことで、サイクルコストを4 から 3 に削減しています。
ldr r4, [r0, #(x_offset / 32 * 4)]
ubfx r3, r4, #(x_offset % 32), #(width)
orr r2, r3, lsl #(x % 32)
ジェネレータのループ処理 (symbolasm ドキュメント化済み)
以下のコードは、ギlyph が蓄積器を跨ぐ場合のみを対象とした内ループです。各値は
g- オフセット計算: パッキングビットマップ内のオフセットとビット/ワードオフセットの分解
- UBFX 命令: ビットフィールド抽出テーブルから最適化された指令を取得
- 左ベアリング処理:
とpen
を足し、シフト量を計算left - ブランチ制御: オフセットが 32 バイト境界を跨ぐ場合の特別処理
loop {
    g @r12 = *(glyphs + c * 4)
    // 次の文字を読み取る
    c = *text++
    width @r7 = g[20..26]
    bit_offset @r4 = g & 31

    if width == 0 goto blank

    ubfx_instr @r11 = *(ubfx_table + bit_offset * 4)

    word_offset @r4 = g >> 5
    ldr @r4 = ldr_base + (word_offset << 6)
    ubfx_instr += width << 16
    *slot = ldr

    left @r4 = (g as i32)[16..20]
    *(code as *u32) = ubfx_instr

    shift @r4 = pen + left
    room @r7 = 32 - width
    pen += g >> 26
    #(shift - room)

    if #hi goto off_word

    // デレイ:orr r2, r2, r3, lsl #shift
    d @r12 = *(orr_table + shift * 4)
    *((code + 6) as *u32) = d

    slot = code + 4
    code += 10
    #(n -= 1)

    if #ne goto loop
}
機械語とサイクル計数分析
symbolasm アナライズツールによる分析結果では、基本ループ(ライン 134-164)は1 反復あたり 23 サイクルで動作します。
- K フラグ: ブランチ条件が不明確な場合の遅延(0〜2 サイクル)。
- H フラグ: hi レジスタ使用による 32 ビット命令を示す。
パフォーマンス評価
理論値と実測値
- 基本ループ: 1 ギlyph あたり23 サイクル。
- ビットマップ生成: 高さ × 3 サイクル。
- 追加コスト: JIT 生成約 20 サイクル + 出力幅(32 ビット)× 高さの 2 サイクル。
- 総体的な速度: 驚くほど高速で、vic-2350 の
では全プロセスに約 6.3k サイクルを要します。textdemo - スループット: RP2350 の単一コア利用可能スループットの約**2.6%**に相当します(565 フォーマット展開の 3 倍コストを除いても)。
比較と特徴
- 汎用性: ビームレース方式だけでなく、1 ピクセル/1 ビットフレームバッファへの書き込みにしても機能します。
- キャッシュ戦略: JIT 出力をキャッシュするのではなく、RAM を節約することを優先しています(JIT 出力は入力文字列の約 10 倍に膨張するため)。
- 既存ライブラリとの比較:
(Michael Bell) との比較では、本実装の方が圧倒的に高速で、かつ RGB222 モード制限やグリッドサイズ制限を回避しています。dvhstx
AI と開発プロセスへの開示
- 開発の背景: 手書きされた Rust コードを基盤とし、Claude を使用して
に翻訳・最適化しました。symbolasm - LLM の活用:
- LLM は境界ケースを見つけやすくし、品質向上に貢献しています。
- しかし、コンテンツの大半が AI 由来になるため、今回は未掲載としています。
- バランスの難しさ: 品質と LLM による加速性のバランスを取りながら開発を進めています。
- 先行事例: テキスト描画専用 JIT の直接的な先行事例は見当たりませんが、1982 年頃の Blit 向けビットブロート(bitblt)コード生成技術とは精神が通じます。
結論: RP2350 ハードウェア上の生パフォーマンスは、過去の Bitblt 実装(約 2,500 文字/秒)に比べてほぼ3 オーダー以上高く、1bpp 出力のみでも十分に高性能であることが確認されました。